概览:在上一篇搭好的 Nautilus 集群上把存储真正用起来
RBD 创建 / 映射 / 挂载 / 扩容 → 集群告警处理 → CephFS 部署与两种挂载方式
RBD 块存储
块存储是存储区域网络中使用的一个数据存储类型。在这种类型中,数据以块的形式存储在卷里,卷会挂载到节点上。可以为应用程序提供更大的存储容量,并且可靠性和性能都更高。
RBD协议,也就是Ceph块设备 (Ceph Block Device)。RBD除了可靠性和性能之外,还支持完整和增量式快照,精简的配置,写时复制(copy-on-write)式克隆。并且支持全内存式缓存。
目前CEPH RBD支持的最大镜像为16EB,镜像可以直接作为磁盘映射到物理裸机,虚拟机或者其他主机使用,KVM和Xen完全支持RBD,VMware等云厂商也支持RBD模式
1,创建资源池Pool 1 2 3 4 5 ceph osd pool create fengqing 64 64
2,查看pool池
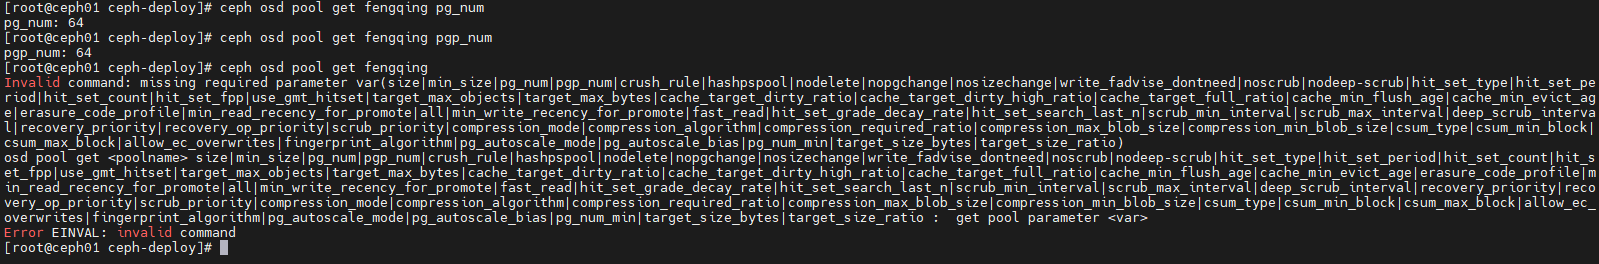
1 2 3 4 ceph osd pool get fengqing pg_num ceph osd pool get fengqing pgp_num ceph osd pool get fengqing
3,查看副本数量 1 2 3 4 5 6 7 [root@ceph01 ceph-deploy]# ceph osd pool get fengqing size size: 3 [root@ceph01 ceph-deploy]# ceph osd pool set fengqing size 2 set pool 1 size to 2[root@ceph01 ceph-deploy]# ceph osd pool get fengqing size size: 2
4,RBD创建和映射
在创建镜像前我们还需要修改一下features值
在Centos7内核上,rbd很多特性都不兼容,目前3.0内核仅支持layering。所以我们需要删除其他特性
layering: 支持分层
striping: 支持条带化 v2
exclusive-lock: 支持独占锁
object-map: 支持对象映射(依赖 exclusive-lock)
fast-diff: 快速计算差异(依赖 object-map)
deep-flatten: 支持快照扁平化操作
journaling: 支持记录 IO 操作(依赖独占锁)
关闭不支持的特性一种是通过命令的方式修改,还有一种是在ceph.conf中添加rbd_default_features = 1来设置默认 features(数值仅是 layering 对应的 bit 码所对应的整数值)。
features编码如下
例如需要开启layering和striping,rbd_default_features = 3 (1+2)
1 2 3 4 5 6 7 属性 BIT码 layering 1 striping 2 exclusive-lock 4 object-map 8 fast-diff 16 deep-flatten 32
设置方式如下(改默认值对新建 image 生效;已建的 image 用 feature disable 逐个关)
1 2 3 4 5 6 7 8 9 [root@ceph01 ~]# cd /root/ceph-deploy [root@ceph01 ceph-deploy]# echo "rbd_default_features = 1" >>ceph.conf [root@ceph01 ceph-deploy]# ceph-deploy --overwrite-conf config push ceph01 ceph02 ceph03 rbd feature disable fengqing/fengqing-rbd.img deep-flatten rbd feature disable fengqing/fengqing-rbd.img fast-diff rbd feature disable fengqing/fengqing-rbd.img object-map rbd feature disable fengqing/fengqing-rbd.img exclusive-lock
1 2 3 [root@ceph01 ceph-deploy]# rbd create -p fengqing --image fengqing-rbd.img --size 15G [root@ceph01 ceph-deploy]# rbd create -p fengqing --image fengqing1-rbd.img --size 15G
5,查看rbd 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 [root@ceph01 ceph-deploy]# rbd -p fengqing ls fengqing-rbd.img [root@ceph01 ceph-deploy]# rbd info -p fengqing --image fengqing-rbd.img rbd image 'fengqing-rbd.img' : size 15 GiB in 3840 objects order 22 (4 MiB objects) snapshot_count: 0 id : 11cd9ca6add7 block_name_prefix: rbd_data.11cd9ca6add7 format: 2 features: layering op_features: flags: create_timestamp: Thu May 12 13:51:54 2022 access_timestamp: Thu May 12 13:51:54 2022 modify_timestamp: Thu May 12 13:51:54 2022 [root@ceph01 ceph-deploy]# rbd info fengqing/fengqing-rbd.img rbd image 'fengqing-rbd.img' : size 15 GiB in 3840 objects order 22 (4 MiB objects) snapshot_count: 0 id : 11cd9ca6add7 block_name_prefix: rbd_data.11cd9ca6add7 format: 2 features: layering op_features: flags: create_timestamp: Thu May 12 13:51:54 2022 access_timestamp: Thu May 12 13:51:54 2022 modify_timestamp: Thu May 12 13:51:54 2022
6,删除rbd 1 2 [root@ceph01 ceph-deploy]# rbd rm fengqing/fengqing1-rbd.img Removing image: 100% complete...done.
7,块文件挂载
接下来我们要进行rbd的挂载 (这里不建议分区,如果分区,后续扩容比较麻烦,容易存在丢数据的情况。在分区不够的情况下建议多块rbd)
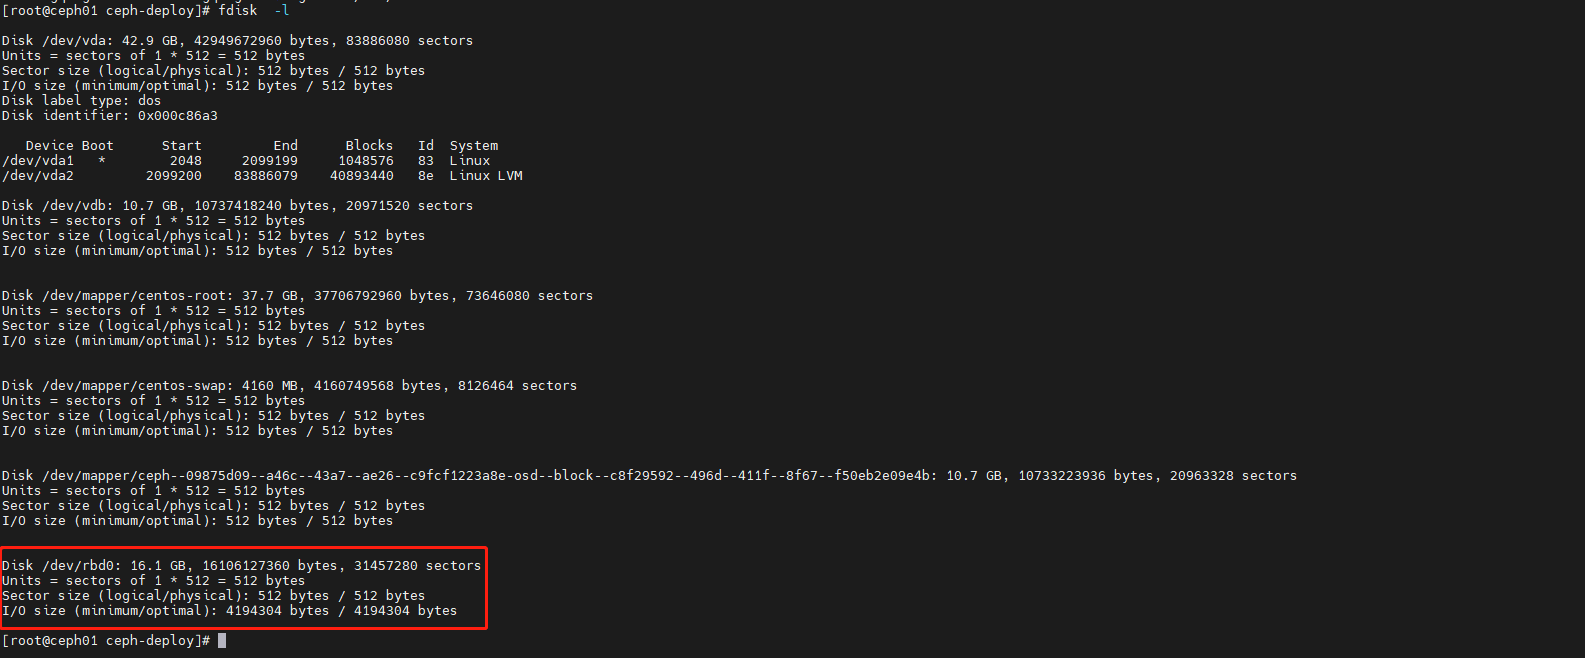
1 2 3 4 [root@ceph01 ceph-deploy]# rbd map fengqing/fengqing-rbd.img /dev/rbd0
1 2 3 4 5 [root@ceph01 ceph-deploy]# rbd device list id pool namespace image snap device0 fengqing fengqing-rbd.img - /dev/rbd0
这里不建议进行分区
接下来进行格式化操作
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 [root@ceph01 ceph-deploy]# mkfs.ext4 /dev/rbd0 mke2fs 1.42.9 (28-Dec-2013) Discarding device blocks: done Filesystem label= OS type : Linux Block size=4096 (log =2) Fragment size=4096 (log =2) Stride=1024 blocks, Stripe width=1024 blocks 983040 inodes, 3932160 blocks 196608 blocks (5.00%) reserved for the super user First data block=0 Maximum filesystem blocks=2151677952 120 block groups 32768 blocks per group, 32768 fragments per group 8192 inodes per group Superblock backups stored on blocks: 32768, 98304, 163840, 229376, 294912, 819200, 884736, 1605632, 2654208 Allocating group tables: done Writing inode tables: done Creating journal (32768 blocks): done Writing superblocks and filesystem accounting information: done
现在就可以进行挂载使用了
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 [root@ceph01 ceph-deploy]# mkdir /mnt/fengqing [root@ceph01 ceph-deploy]# mount /dev/rbd0 /mnt/fengqing [root@ceph01 ceph-deploy]# df -h Filesystem Size Used Avail Use% Mounted on devtmpfs 1.9G 0 1.9G 0% /dev tmpfs 1.9G 0 1.9G 0% /dev/shm tmpfs 1.9G 8.6M 1.9G 1% /run tmpfs 1.9G 0 1.9G 0% /sys/fs/cgroup /dev/mapper/centos-root 36G 2.2G 33G 7% / /dev/vda1 1014M 192M 823M 19% /boot tmpfs 379M 0 379M 0% /run/user/0 tmpfs 1.9G 52K 1.9G 1% /var/lib/ceph/osd/ceph-0 /dev/rbd0 15G 41M 14G 1% /mnt/fengqing [root@ceph01 ceph-deploy]# cd /mnt/fengqing/ [root@ceph01 fengqing]# ls lost+found [root@ceph01 fengqing]# touch fengqing.txt [root@ceph01 fengqing]# echo "helloword" >fengqing.txt [root@ceph01 fengqing]# cat fengqing.txt helloword
8,RBD扩容
目前我们的rbd大小为15个G,这里我们演示将它扩展到30G。在不丢数据的情况下
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 [root@ceph01 fengqing]# rbd -p fengqing ls fengqing-rbd.img [root@ceph01 fengqing]# rbd info fengqing/fengqing-rbd.img rbd image 'fengqing-rbd.img' : size 15 GiB in 3840 objects order 22 (4 MiB objects) snapshot_count: 0 id : 11cd9ca6add7 block_name_prefix: rbd_data.11cd9ca6add7 format: 2 features: layering op_features: flags: create_timestamp: Thu May 12 13:51:54 2022 access_timestamp: Thu May 12 13:51:54 2022 modify_timestamp: Thu May 12 13:51:54 2022 [root@ceph01 fengqing]# df -h Filesystem Size Used Avail Use% Mounted on devtmpfs 1.9G 0 1.9G 0% /dev tmpfs 1.9G 0 1.9G 0% /dev/shm tmpfs 1.9G 8.6M 1.9G 1% /run tmpfs 1.9G 0 1.9G 0% /sys/fs/cgroup /dev/mapper/centos-root 36G 2.2G 33G 7% / /dev/vda1 1014M 192M 823M 19% /boot tmpfs 379M 0 379M 0% /run/user/0 tmpfs 1.9G 52K 1.9G 1% /var/lib/ceph/osd/ceph-0 /dev/rbd0 15G 41M 14G 1% /mnt/fengqing
接下来使用resize参数进行扩容
1 2 3 4 5 [root@ceph01 fengqing]# rbd resize fengqing/fengqing-rbd.img --size 30G Resizing image: 100% complete...done.
查看
1 2 3 4 5 6 7 8 9 10 11 12 13 14 [root@ceph01 fengqing]# rbd info fengqing/fengqing-rbd.img rbd image 'fengqing-rbd.img' : size 30 GiB in 7680 objects order 22 (4 MiB objects) snapshot_count: 0 id : 11cd9ca6add7 block_name_prefix: rbd_data.11cd9ca6add7 format: 2 features: layering op_features: flags: create_timestamp: Thu May 12 13:51:54 2022 access_timestamp: Thu May 12 13:51:54 2022 modify_timestamp: Thu May 12 13:51:54 2022
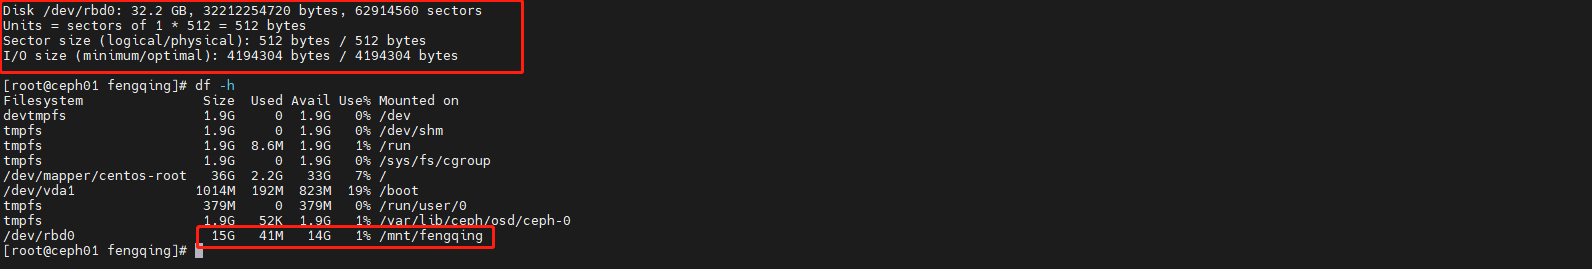
扩容之后我们的设备是已经扩容上去,但是我们的文件系统并没有扩容上
接下来我们需要使用resize2fs对文件系统进行扩容
关于resize2fs解释:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 [root@ceph01 fengqing]# resize2fs /dev/rbd0 resize2fs 1.42.9 (28-Dec-2013) Filesystem at /dev/rbd0 is mounted on /mnt/fengqing; on-line resizing required old_desc_blocks = 2, new_desc_blocks = 4 The filesystem on /dev/rbd0 is now 7864320 blocks long. [root@ceph01 fengqing]# df -h Filesystem Size Used Avail Use% Mounted on devtmpfs 1.9G 0 1.9G 0% /dev tmpfs 1.9G 0 1.9G 0% /dev/shm tmpfs 1.9G 8.6M 1.9G 1% /run tmpfs 1.9G 0 1.9G 0% /sys/fs/cgroup /dev/mapper/centos-root 36G 2.2G 33G 7% / /dev/vda1 1014M 192M 823M 19% /boot tmpfs 379M 0 379M 0% /run/user/0 tmpfs 1.9G 52K 1.9G 1% /var/lib/ceph/osd/ceph-0 /dev/rbd0 30G 44M 28G 1% /mnt/fengqing
我们可以到挂载的目录进行查看,之前创建的数据也还在
1 2 3 4 [root@ceph01 fengqing]# cat fengqing.txt helloword [root@ceph01 fengqing]# pwd /mnt/fengqing
对于扩容一般会涉及三方面的内容: 1.底层存储(rbd resize) 2.磁盘分区的扩容 (例如mbr分区) 3.Linux文件系统的扩容
CEPH警告处理 1,警告处理 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 [root@ceph01 fengqing]# ceph -s cluster: id : cae384c6-2be0-4bee-8f76-2f02941d71ee health: HEALTH_WARN application not enabled on 1 pool(s) 943 slow ops, oldest one blocked for 1677 sec, mon.ceph02 has slow ops clock skew detected on mon.ceph02 services: mon: 3 daemons, quorum ceph01,ceph02,ceph03 (age 28m) mgr: ceph01(active, since 4h), standbys: ceph03 osd: 3 osds: 3 up (since 4h), 3 in (since 4h) data: pools: 1 pools, 64 pgs objects: 69 objects, 141 MiB usage: 3.3 GiB used, 27 GiB / 30 GiB avail pgs: 64 active+clean io: client: 510 B/s rd, 0 op/s rd, 0 op/s wr
当我们创建pool资源池后,必须制定它使用ceph应用的类型 (ceph块设备、ceph对象网关、ceph文件系统)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 [root@ceph01 fengqing]# ceph -s cluster: id : cae384c6-2be0-4bee-8f76-2f02941d71ee health: HEALTH_WARN application not enabled on 1 pool(s) 943 slow ops, oldest one blocked for 1677 sec, mon.ceph02 has slow ops clock skew detected on mon.ceph02 services: mon: 3 daemons, quorum ceph01,ceph02,ceph03 (age 28m) mgr: ceph01(active, since 4h), standbys: ceph03 osd: 3 osds: 3 up (since 4h), 3 in (since 4h) data: pools: 1 pools, 64 pgs objects: 69 objects, 141 MiB usage: 3.3 GiB used, 27 GiB / 30 GiB avail pgs: 64 active+clean io: client: 510 B/s rd, 0 op/s rd, 0 op/s wr [root@ceph01 fengqing]# ceph health detail HEALTH_WARN application not enabled on 1 pool(s); 1033 slow ops, oldest one blocked for 1827 sec, mon.ceph02 has slow ops; clock skew detected on mon.ceph02 POOL_APP_NOT_ENABLED application not enabled on 1 pool(s) application not enabled on pool 'fengqing' use 'ceph osd pool application enable <pool-name> <app-name>' , where <app-name> is 'cephfs' , 'rbd' , 'rgw' , or freeform for custom applications. SLOW_OPS 1033 slow ops, oldest one blocked for 1827 sec, mon.ceph02 has slow ops MON_CLOCK_SKEW clock skew detected on mon.ceph02 mon.ceph02 clock skew 946.677s > max 0.05s (latency 0.00234324s)
三条告警的处理:application 告警按下面的 enable 分类解决;slow ops 和 clock skew 都出在 mon.ceph02 的时钟上(偏了 900 多秒),把它时间同步好、重启该 mon 后就消失了——所以最后的 ceph -s 里 mon 的 age 才会归零。
接下来我们将这个pool资源池进行分类,将fengqing pool标示为rbd类型
1
2
[root@ceph01 fengqing]# ceph osd pool application enable fengqing rbd enabled application 'rbd' on pool 'fengqing'
如果我们在创建pool进行初始化后,就不会提示这个报错rbd pool init <pool-name>
当我们初始化后,rbd会将我们的pool修改为rbd格式。 健康状态自然就不会报错
设置完毕后,我们通过下面的命令可以看到pool目前的类型属于rbd类型
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 [root@ceph01 fengqing]# ceph -s cluster: id : cae384c6-2be0-4bee-8f76-2f02941d71ee health: HEALTH_OK services: mon: 3 daemons, quorum ceph01,ceph02,ceph03 (age 1.72301s) mgr: ceph01(active, since 4h), standbys: ceph02, ceph03 osd: 3 osds: 3 up (since 4h), 3 in (since 4h) data: pools: 1 pools, 64 pgs objects: 69 objects, 141 MiB usage: 3.3 GiB used, 27 GiB / 30 GiB avail pgs: 64 active+clean
CephFS文件系统
为什么需要使用CephFS CephFS文件系统
1,安装mds 1 2 ceph-deploy mds create ceph01 ceph02 ceph03
2,查看mds 1 2 [root@ceph01 ceph-deploy]# ceph -s|grep mds mds: 3 up:standby
3,创建pool 一个Ceph文件系统至少需要两个RADOS池,一个用于数据,一个用于元数据。
对元数据池使用更好的复制级别,因为此池中的任何数据丢失都可能导致整个文件系统无法访问
对元数据池使用SSD等低延迟存储,因为这将直接影响观察到的客户端文件系统操作的延迟。
用于创建文件的数据池是默认数据池,是存储所有inode回溯信息的位置,用于硬链接管理和灾难恢复。因此,在CephFS中创建的所有inode在默认数据池中至少有一个对象。
创建存储池,数据data,元数据metadata
1 2 3 4 5 6 7 8 [root@ceph01 ceph-deploy]# ceph osd pool create cephfs_data 64 64 pool 'cephfs_data' created [root@ceph01 ceph-deploy]# ceph osd pool create cephfs_metadata 64 64 pool 'cephfs_metadata' created [root@ceph01 ceph-deploy]# ceph osd pool ls fengqing cephfs_data cephfs_metadata
通常,元数据池最多有几GB的数据,建议使用比较小的PG数,64或者128常用于大型集群
4,创建文件系统
接下来需要创建文件系统,将刚刚创建的pool关联起来
1 2 3 4 5 [root@ceph01 ceph-deploy]# ceph fs new cephfs-abcdocker cephfs_metadata cephfs_data new fs with metadata pool 3 and data pool 2
5,查看文件系统 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 [root@ceph01 ceph-deploy]# ceph fs ls name: cephfs-abcdocker, metadata pool: cephfs_metadata, data pools: [cephfs_data ] [root@ceph01 ceph-deploy]# ceph -s cluster: id : cae384c6-2be0-4bee-8f76-2f02941d71ee health: HEALTH_OK services: mon: 3 daemons, quorum ceph01,ceph02,ceph03 (age 9m) mgr: ceph01(active, since 5h), standbys: ceph02, ceph03 mds: cephfs-abcdocker:1 {0=ceph03=up:active} 2 up:standby osd: 3 osds: 3 up (since 19m), 3 in (since 5h) task status: data: pools: 3 pools, 192 pgs objects: 92 objects, 141 MiB usage: 3.3 GiB used, 27 GiB / 30 GiB avail pgs: 192 active+clean
6,挂载
使用cephfs
1 2 3 4 5 6 7 8 9 10 11 12 13 14 [root@ceph01 ceph-deploy]# mkdir /fengqing1 [root@ceph01 ceph-deploy]# mount -t ceph ceph01:6789:/ /fengqing1 -o name=admin [root@ceph01 ceph-deploy]# df -h Filesystem Size Used Avail Use% Mounted on devtmpfs 1.9G 0 1.9G 0% /dev tmpfs 1.9G 0 1.9G 0% /dev/shm tmpfs 1.9G 8.6M 1.9G 1% /run tmpfs 1.9G 0 1.9G 0% /sys/fs/cgroup /dev/mapper/centos-root 36G 2.2G 33G 7% / /dev/vda1 1014M 192M 823M 19% /boot tmpfs 379M 0 379M 0% /run/user/0 tmpfs 1.9G 52K 1.9G 1% /var/lib/ceph/osd/ceph-0 /dev/rbd0 30G 44M 28G 1% /mnt/fengqing 192.168.150.26:6789:/ 8.4G 0 8.4G 0% /fengqing1
在内核中挂载性能会比较高一点,但是有一些场景内核可能不太支持,所以可以使用用户FUSE挂载
用户空间挂载主要使用的是ceph-fuse客户端,需要单独安装。如果是在集群外的机器上挂载,要先把 ceph.conf 和 ceph.client.admin.keyring 拷到那台机器的 /etc/ceph/(下面的 scp 演示的就是这个,以集群外的 150.40 为例);我这里为了方便,直接在 ceph01 上演示挂载
首先要把ceph.conf和ceph.client.admin.keyring拷贝到对应的机子上,ceph-fuse 要读取这两个文件
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 yum install ceph-fuse -y mkdir /fengqing3 ceph-fuse -n client.admin -m 192.168.150.26:6789 /fengqing3 [root@ceph01 ceph-deploy]# df -h Filesystem Size Used Avail Use% Mounted on devtmpfs 1.9G 0 1.9G 0% /dev tmpfs 1.9G 0 1.9G 0% /dev/shm tmpfs 1.9G 8.6M 1.9G 1% /run tmpfs 1.9G 0 1.9G 0% /sys/fs/cgroup /dev/mapper/centos-root 36G 2.2G 33G 7% / /dev/vda1 1014M 192M 823M 19% /boot tmpfs 379M 0 379M 0% /run/user/0 tmpfs 1.9G 52K 1.9G 1% /var/lib/ceph/osd/ceph-0 /dev/rbd0 30G 44M 28G 1% /mnt/fengqing 192.168.150.26:6789:/ 8.4G 0 8.4G 0% /fengqing1 ceph-fuse 8.4G 0 8.4G 0% /fengqing3
client.admin 默认有一个client.admin的用户
192.168.150.26:6789 mon地址 (也可以写多个,逗号分隔)
如果我们不指定mon,默认找的是/etc/ceph/ceph.conf里面的配置文件
参考:本文实操过程参考了 abcdocker(i4t.com)的 Ceph 系列教程,所有命令输出均来自我自己的集群。